Audio–visual keyword transformer for unconstrained sentence‐level keyword spotting
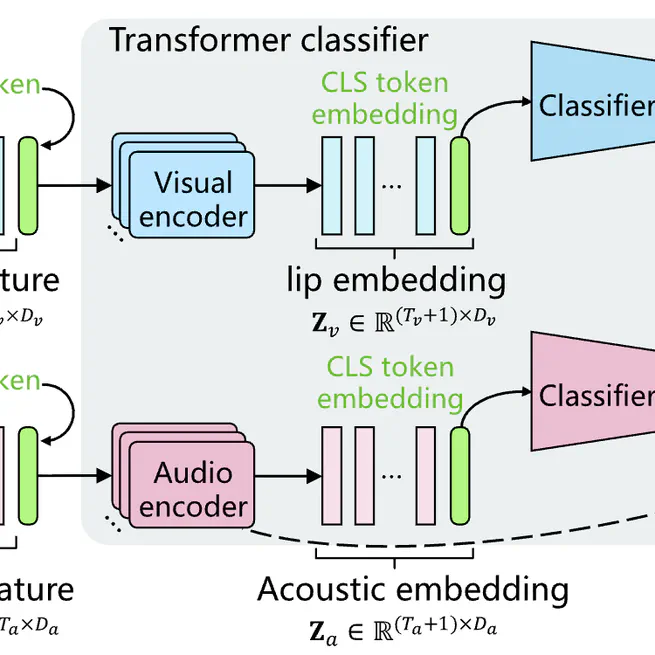
An Audio–Visual Keyword Transformer (AVKT) network for keyword spotting in unconstrained video clips, using transformer classifier with learnable CLS tokens and decision fusion to achieve high accuracy in both clean and noisy conditions.
Feb 1, 2024